




Alert zwykle ma nudny temat: zdarzenie DegradedArray na /dev/md0. Jeden dysk w programowym RAID w Linuksie wypadł, serwer nadal działa i kusi, żeby zostawić to do przyszłego tygodnia. Nie rób tego. Zdegradowana macierz RAID nie ma już redundancji dla zapisanych na niej danych, a pozostałe dyski są często w tym samym wieku i tego samego modelu co ten, który właśnie padł. Ten poradnik pokazuje, jak spokojnie wymienić uszkodzony dysk w mdadm, na typowej macierzy RAID 1, 5, 6 lub 10, żeby awaria dysku nie zamieniła się w utratę danych.
Krok 1: sprawdź status RAID w Linuksie, zanim czegokolwiek dotkniesz
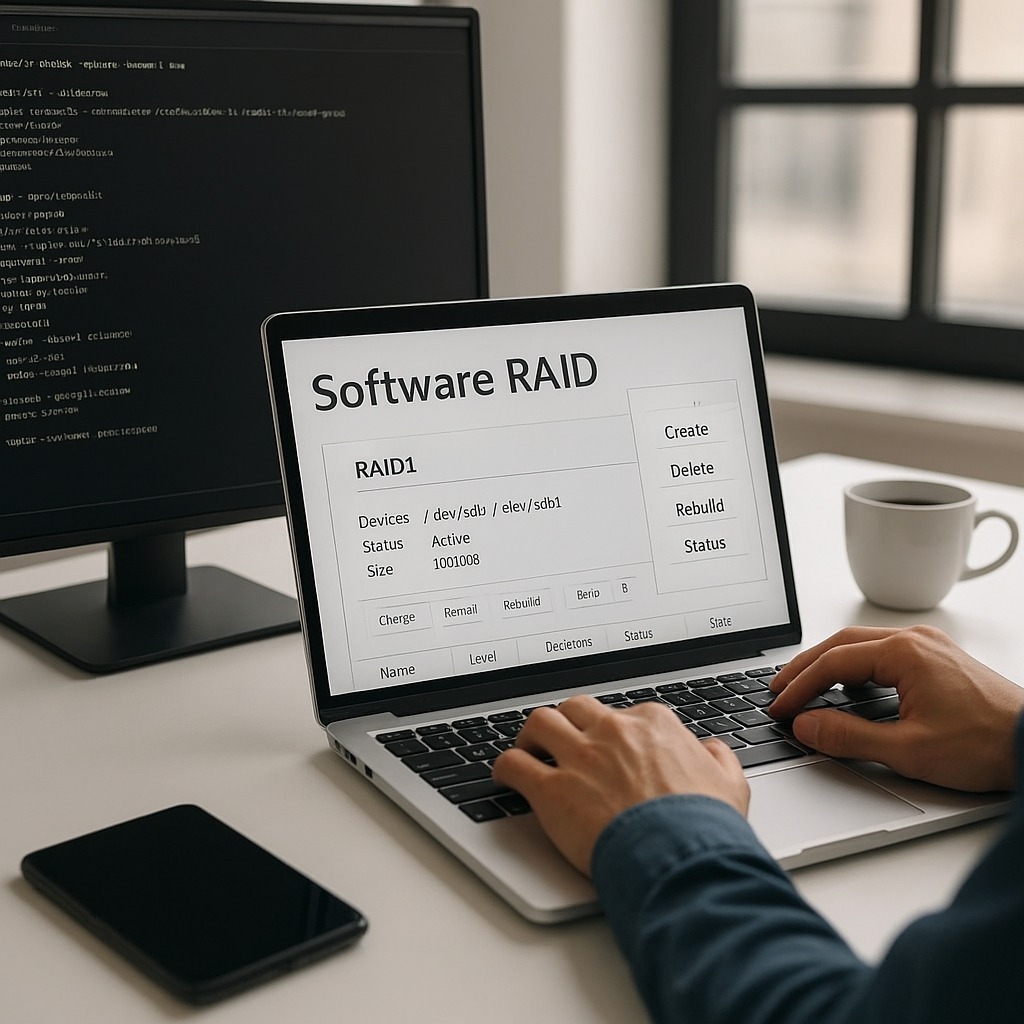
Zacznij od odczytania tego, co zgłasza system. Plik /proc/mdstat podaje krótkie podsumowanie dla każdej macierzy; zdrowe dwudyskowe lustro pokazuje [UU], a zdegradowane [U_]. Szczegóły daje mdadm --detail /dev/md0, które wymienia każde urządzenie członkowskie wraz ze stanem (active, faulty, removed lub spare) i pokazuje, czy trwa resynchronizacja lub odzyskiwanie. Zanotuj, które partycje należą do której macierzy, bo wiele serwerów ma osobne macierze dla /boot, swap i danych na tych samych dyskach.
Następnie potwierdź kopie zapasowe. Odbudowa czyta każdy blok na pozostałych dyskach, a to dokładnie ten moment, w którym zwykle pada drugi słaby dysk. Jeśli ostatnia kopia jest stara lub nieprzetestowana, najpierw skopiuj ważne dane w bezpieczne miejsce.
Krok 2: rozpoznaj uszkodzony dysk po numerze seryjnym
Nazwy urządzeń, takie jak /dev/sdb, mogą zmieniać się między restartami, a wyciągnięcie złego dysku ze zdegradowanego lustra kończy się źle. Zawsze rozpoznawaj uszkodzony dysk po numerze seryjnym. Linki w /dev/disk/by-id zawierają model i numer seryjny, a smartctl -i /dev/sdb z pakietu smartmontools także drukuje numer seryjny. Zapisz go, a potem porównaj z etykietą na fizycznym dysku lub informacją o wnęce od dostawcy hostingu.
Gdy smartctl jest już otwarty, sprawdź pozostałe dyski poleceniem smartctl -a. Realokowane lub oczekujące sektory na dysku, który ocalał, zmieniają plan: skopiuj dane przed odbudową, zamiast ufać, że odbudowa się zakończy.
Krok 3: usuń uszkodzony element macierzy
Jeśli mdadm już oznaczył dysk jako faulty, usuń go z macierzy. Jeśli dysk zawodzi, ale jest jeszcze aktywny, najpierw oznacz go jako faulty. Dla każdej macierzy, która używa tego dysku:
- mdadm /dev/md0 --fail /dev/sdb1, tylko jeśli nie jest już oznaczony jako faulty
- mdadm /dev/md0 --remove /dev/sdb1
Powtórz to dla każdej partycji tego dysku w innych macierzach, takich jak /dev/md1. Dysk można wtedy wymienić: na gorąco, jeśli sprzęt to obsługuje, albo po zaplanowanym wyłączeniu. Na serwerach dzierżawionych otwórz zgłoszenie z numerem seryjnym i poproś dostawcę o wymianę dokładnie tego dysku.
Jeszcze lepiej: wymień zawodzący dysk przez mdadm --replace
Jeśli dysk pokazuje tylko ostrzeżenia, możesz całkowicie uniknąć okresu degradacji. Dodaj nowy dysk do macierzy jako spare, a potem uruchom mdadm /dev/md0 --replace /dev/sdb1 --with /dev/sdc1. mdadm kopiuje dane na nowy dysk, podczas gdy stary pozostaje w macierzy, i dopiero potem oznacza stary jako faulty. Redundancja jest zachowana przez cały czas, dlatego mdadm --replace to preferowana droga, gdy tylko w serwerze jest miejsce na jeszcze jeden dysk.
Krok 4: wymień uszkodzony dysk w mdadm i uruchom odbudowę
Dysk zastępczy musi być co najmniej tak duży jak ten, który zastępuje. Skopiuj układ partycji ze sprawnego elementu zamiast tworzyć go ręcznie:
- Dyski GPT: sgdisk --replicate=/dev/sdb /dev/sda kopiuje tablicę partycji z sda na nowy sdb, a sgdisk --randomize-guids /dev/sdb nadaje nowemu dyskowi własne identyfikatory.
- Starsze dyski MBR: sfdisk -d /dev/sda | sfdisk /dev/sdb robi to samo.
Sprawdź dwukrotnie kierunek kopiowania, zanim naciśniesz Enter, bo odwrócenie dwóch urządzeń nadpisze tablicę partycji dobrego dysku. Potem dodaj każdą nową partycję do jej macierzy poleceniem mdadm /dev/md0 --add /dev/sdb1, a odbudowa mdadm ruszy sama.
Krok 5: obserwuj odbudowę i napraw bootloader
cat /proc/mdstat pokazuje postęp odzyskiwania i szacowany czas zakończenia. Czas odbudowy RAID zależy głównie od wielkości dysku i od tego, jak zajęty jest serwer, bo jądro dławi odbudowę, żeby zostawić miejsce na normalną pracę; limity znajdują się w /proc/sys/dev/raid/speed_limit_min i speed_limit_max. Na dużych dyskach odbudowa może trwać wiele godzin, więc jeśli możesz, odłóż ciężkie zadania, takie jak pełne kopie zapasowe.
Jeśli serwer startuje z macierzy, nowy dysk potrzebuje też bootloadera. W przeciwnym razie serwer nie wystartuje następnym razem, gdy padnie ten drugi dysk. W systemach BIOS oznacza to uruchomienie grub-install na nowym dysku; w systemach UEFI trzeba odtworzyć partycję systemową EFI na nowym dysku, skopiować jej zawartość i dodać wpis rozruchowy w firmware. Na koniec sprawdź, czy monitoring nadal obserwuje macierz i czy e-maile z alertami trafiają do prawdziwej osoby.
Częste błędy w zarządzaniu programowym RAID
- Tworzenie macierzy od nowa przez mdadm --create, żeby ją "naprawić". Na macierzy, która przechowuje dane, może to je zniszczyć; złożenie macierzy z istniejących elementów to niemal zawsze właściwe polecenie.
- Wyciągnięcie złego dysku, bo zaufano nazwom urządzeń zamiast numerom seryjnym.
- Zapomnienie o pozostałych macierzach na tym samym dysku, co zostawia swap lub /boot zdegradowane.
- Brak hot spare i alertów, więc pierwsza awaria zostaje niezauważona do drugiej. Dysk hot spare pozwala mdadm zacząć odbudowę w chwili, gdy element padnie.
Większość z tego sprowadza się do pierwotnej konfiguracji RAID w Linuksie. Alerty, bootloader na każdym dysku i spisany układ, wszystko to część starannej konfiguracji RAID mdadm, zamieniają wymianę dysku w rutynową konserwację.
Najczęściej zadawane pytania: wymiana uszkodzonego dysku w mdadm
Czy mogę korzystać z serwera podczas odbudowy macierzy?
Tak. Macierz pozostaje online przez cały czas, tylko wolniej. Ryzyko leży po stronie danych: dopóki odbudowa się nie zakończy, awaria kolejnego elementu może położyć macierz, dlatego aktualna kopia zapasowa jest na pierwszym miejscu.
Odbudowa ciągle startuje od nowa albo zatrzymuje się z błędami odczytu. Co dalej?
Błąd odczytu na dysku, który ocalał, oznacza, że źródło odbudowy też zawodzi. Przestań zapisywać do macierzy, skopiuj dane lub zrób obrazy dysków i od tego miejsca zaplanuj odzyskiwanie, zamiast wymuszać odbudowę.
Czy nowy dysk musi być tego samego modelu?
Nie, ale musi być co najmniej tak duży. Mieszanie bardzo różnych typów dysków w jednej macierzy może ograniczyć całą macierz do szybkości jej najwolniejszego elementu.
Masz zdegradowaną macierz na serwerze w Los Angeles lub gdziekolwiek w Kalifornii? Nasza usługa tworzenia i zarządzania programowym RAID obejmuje wymiany dysków, odbudowy i odzyskiwanie, a większość pracy wykonujemy zdalnie, gdy dysk zastępczy zamontujesz Ty lub Twój dostawca hostingu. Jeśli odbudowa pokaże, że kopie zapasowe też wymagają uwagi, zobacz naszą usługę kopii zapasowych i odzyskiwania po awarii. Skontaktuj się z nami, podając wynik mdadm --detail dla każdej macierzy, a wspólnie ustalimy następny bezpieczny krok.