




警报的主题行通常平淡无奇:/dev/md0 上的 DegradedArray 事件。Linux 软件 RAID 中的一块磁盘已经脱落,服务器仍在运行,让人很想拖到下周再处理。请不要。降级的 RAID 阵列对其上的数据已经没有冗余,而剩下的磁盘往往与刚刚故障的那块同龄、同型号。本指南说明如何在典型的 RAID 1、5、6 或 10 阵列上,从容地更换 mdadm 中的故障磁盘,避免磁盘故障演变成数据丢失。
第 1 步:动手之前先查看 RAID 状态
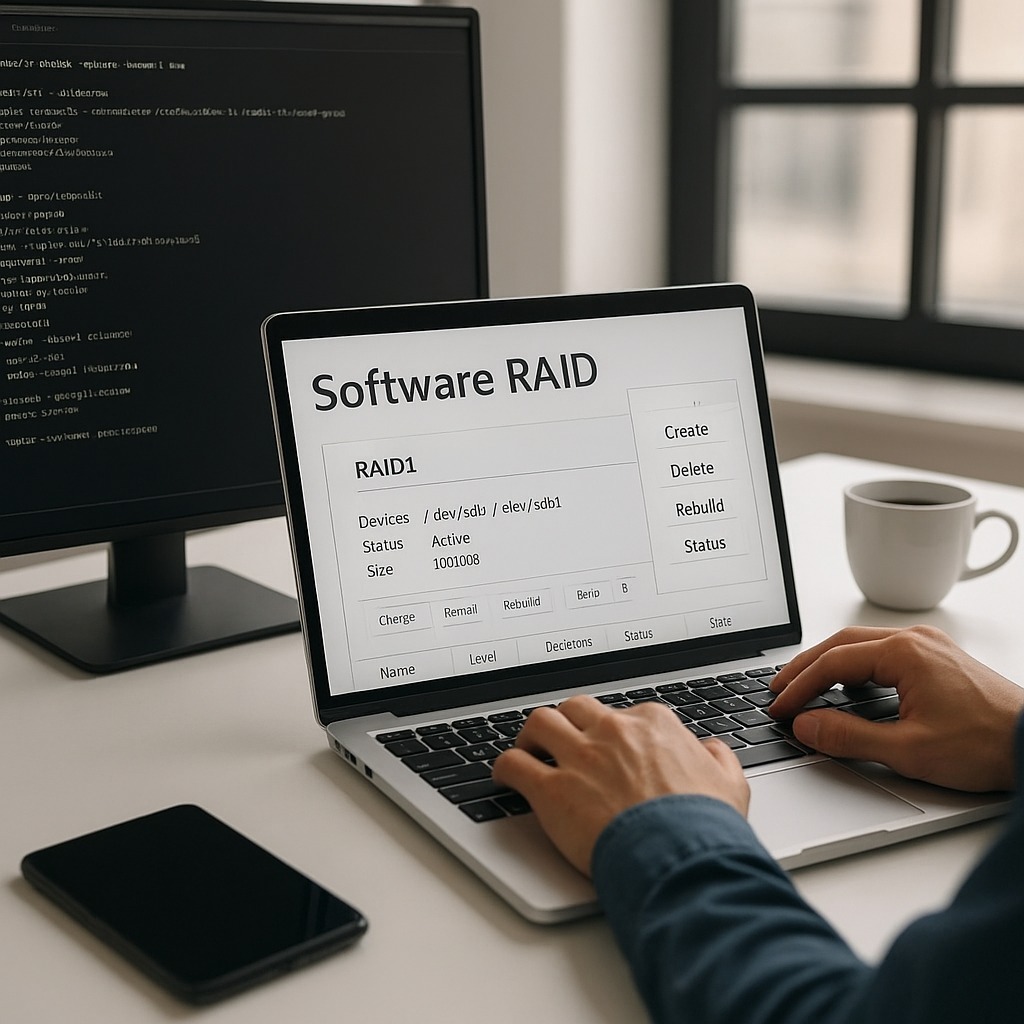
先读取系统报告的内容。文件 /proc/mdstat 按阵列给出简短的摘要;健康的双盘镜像显示 [UU],降级的则显示 [U_]。要看详情,mdadm --detail /dev/md0 会列出每个成员设备及其状态(active、faulty、removed 或 spare),并显示是否正在进行重新同步或恢复。请记下哪些分区属于哪个阵列,因为许多服务器在同样的磁盘上为 /boot、swap 和数据分别建有独立的阵列。
接着,确认备份。重建会读取幸存磁盘上的每一个块,而这恰恰是第二块不够健康的磁盘容易出故障的时刻。如果最新的备份很旧或从未测试过,请先把重要数据复制到安全的地方。
第 2 步:按序列号识别故障磁盘
/dev/sdb 之类的设备名可能在重启之间发生变化,而从降级的镜像中拔错磁盘,结局会很糟糕。请始终按序列号识别故障磁盘。/dev/disk/by-id 下的链接包含型号和序列号,smartmontools 中的 smartctl -i /dev/sdb 也会打印序列号。把它记下来,再与物理磁盘上的标签,或托管服务商提供的盘位信息进行核对。
在 smartctl 还开着的时候,用 smartctl -a 检查幸存的磁盘。幸存磁盘上若出现重映射扇区或待处理扇区,计划就要改变:应在重建之前先把数据复制出来,而不是指望重建能顺利完成。
第 3 步:移除故障成员
如果 mdadm 已经把该磁盘标记为 faulty,就把它从阵列中移除。如果磁盘正在出故障但仍处于活动状态,则先将其标记为 faulty。对使用该磁盘的每个阵列:
- mdadm /dev/md0 --fail /dev/sdb1,仅在它尚未被标记为 faulty 时执行
- mdadm /dev/md0 --remove /dev/sdb1
对该磁盘在其他阵列(例如 /dev/md1)中的每个分区重复这一步。之后就可以更换磁盘了:如果硬件支持,可以热插拔,否则在计划好的关机之后进行。对于租用的服务器,请带着序列号提交工单,并要求服务商更换的正是那块磁盘。
更好的办法:用 mdadm --replace 更换即将故障的磁盘
如果磁盘只是出现警告,您可以完全避开降级的窗口期。先把新磁盘作为备用盘加入阵列,然后运行 mdadm /dev/md0 --replace /dev/sdb1 --with /dev/sdc1。mdadm 会在旧盘仍留在阵列中的情况下把数据复制到新盘,然后才把旧盘标记为 faulty。冗余全程得以保留,因此只要服务器还有空间再插一块磁盘,mdadm --replace 就是首选的做法。
第 4 步:更换 mdadm 故障磁盘并开始重建
替换的磁盘容量必须不小于被替换的磁盘。请从健康的成员复制分区布局,而不是手工创建:
- GPT 磁盘:sgdisk --replicate=/dev/sdb /dev/sda 会把分区表从 sda 复制到新的 sdb,随后 sgdisk --randomize-guids /dev/sdb 为新磁盘赋予它自己的标识符。
- 较旧的 MBR 磁盘:sfdisk -d /dev/sda | sfdisk /dev/sdb 可以完成同样的工作。
按下 Enter 之前,请再次确认复制的方向,因为把两个设备弄反会覆盖完好磁盘的分区表。然后用 mdadm /dev/md0 --add /dev/sdb1 把每个新分区加入各自的阵列,mdadm 重建就会自动开始。
第 5 步:监视重建并修复引导加载程序
cat /proc/mdstat 会显示恢复进度和预计完成时间。RAID 重建时间主要取决于磁盘大小和服务器的繁忙程度,因为内核会限制重建速度,为正常工作留出余地;限值位于 /proc/sys/dev/raid/speed_limit_min 和 speed_limit_max。大容量磁盘的重建可能持续许多小时,所以如果可以,请推迟完整备份之类的繁重任务。
如果服务器从阵列引导,新磁盘也需要引导加载程序。否则,下次轮到另一块磁盘故障时,服务器将无法启动。在 BIOS 系统上,这意味着在新磁盘上运行 grub-install;在 UEFI 系统上,则要在新磁盘上重新创建 EFI 系统分区,复制其内容并添加固件引导项。最后,检查监控是否仍在监视该阵列,以及警报邮件是否能送到真人手中。
软件 RAID 管理中的常见错误
- 重新创建阵列:用 mdadm --create 来“修复”它。对于存有数据的阵列,这可能会毁掉数据;用现有成员组装阵列,几乎总是正确的命令。
- 拔错磁盘:因为相信了设备名而不是序列号。
- 忘记同一磁盘上的其他阵列:这会让 swap 或 /boot 一直处于降级状态。
- 没有热备盘,也没有警报:第一次故障无人察觉,直到第二次故障到来。有了热备盘,mdadm 就能在成员出故障的那一刻开始重建。
这些问题大多可以追溯到最初的 Linux RAID 配置。警报、每块磁盘上都有的引导加载程序,以及写下来的布局记录,都属于认真的 mdadm RAID 配置的一部分,它们能让更换磁盘变成例行维护。
常见问题:更换 mdadm 故障磁盘
阵列重建期间我还能继续使用服务器吗?
可以。阵列全程保持在线,只是更慢。风险在数据一侧:重建完成之前,另一个成员出故障就可能让阵列瘫痪,所以首先要有最新的备份。
重建不断重启,或因读取错误而停止,怎么办?
幸存磁盘上的读取错误意味着重建的数据源也在出问题。请停止向阵列写入,把数据复制出来或为磁盘做镜像,并以此为基础规划恢复,而不是强行重建。
新磁盘必须是同一型号吗?
不必,但容量必须不小于原来的磁盘。在一个阵列中混用差别很大的硬盘类型,可能让整个阵列的速度被拖到最慢成员的水平。
在洛杉矶(Los Angeles)或加州其他地方的服务器上遇到了降级的阵列?我们的软件 RAID 创建与管理服务涵盖磁盘更换、重建和恢复,在您或您的托管服务商装上替换磁盘之后,大部分工作都可以远程完成。如果重建显示备份也需要关注,请参阅我们的数据备份与灾难恢复服务。请联系我们,附上每个阵列的 mdadm --detail 输出,我们会和您一起研究下一步安全的做法。