





服务器监控简介
服务器监控是跟踪服务器的健康状况和性能,以防止停机,并保证 IT 服务平稳运行。
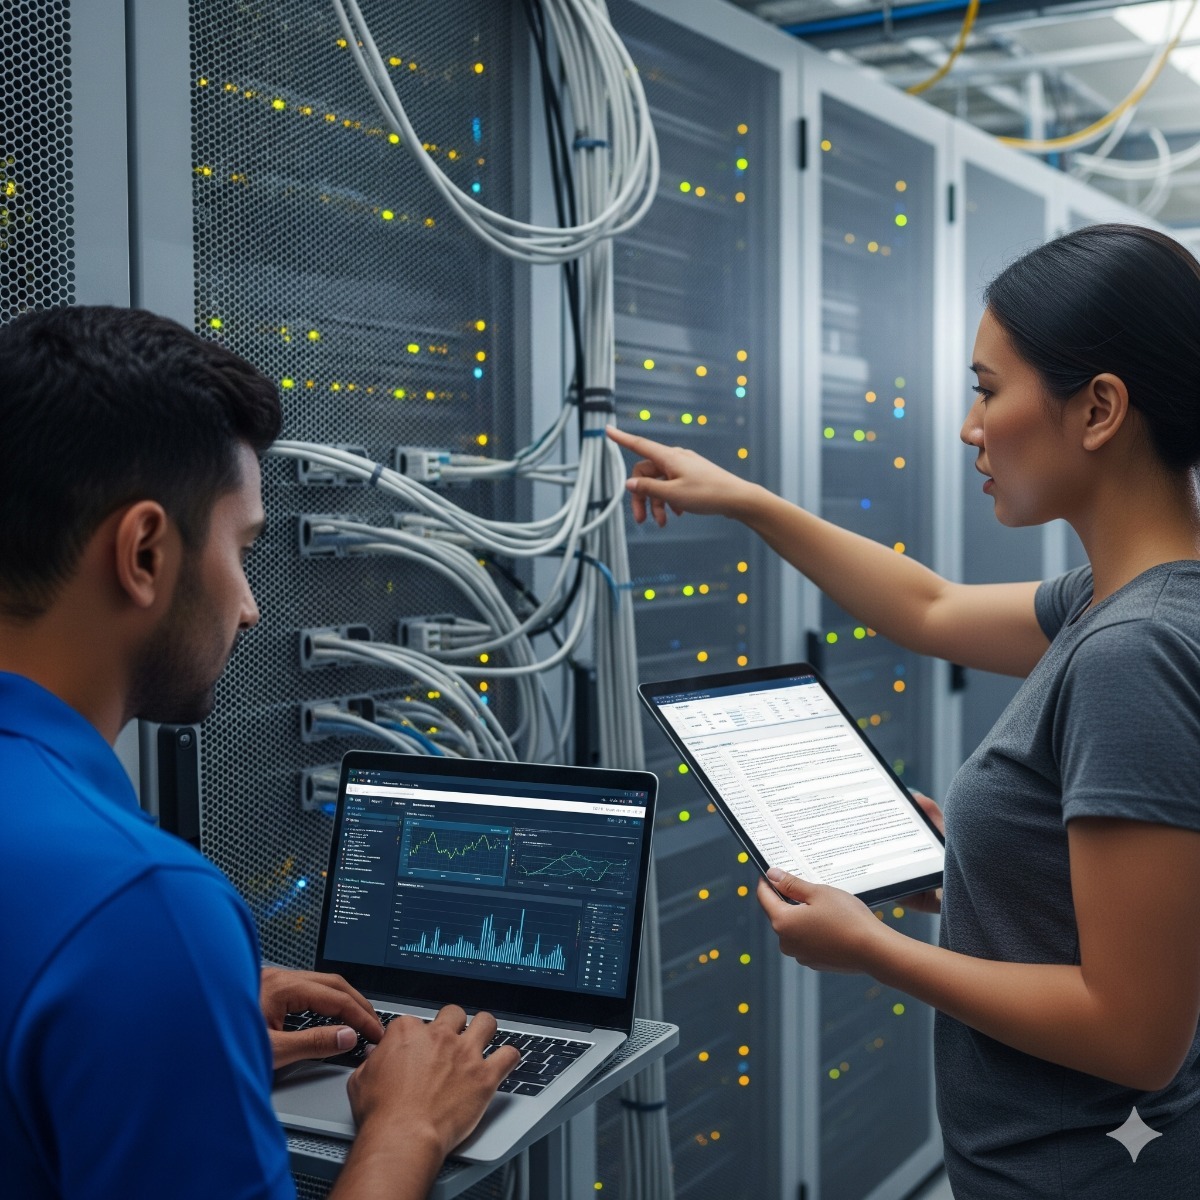
服务器监控的关键方面
- CPU、内存和磁盘使用情况监控
- 网络性能和延迟检查
- 应用和服务的可用性
- 日志监控和错误检测
- 针对异常的警报和通知
服务器维护最佳实践
定期维护有助于预防故障并延长服务器寿命:
- 及时应用更新和安全补丁
- 清理不必要的文件和进程
- 定期检查备份和恢复流程
- 监控硬件健康状况,包括磁盘和电源
- 测试冗余和故障转移机制
监控工具与方案
多种工具可以帮助管理员跟踪服务器的健康状况和性能:
- Nagios、Zabbix 和 Prometheus:系统监控
- Grafana:数据可视化
- Pingdom 和 UptimeRobot:正常运行时间检查
- ELK Stack 或 Splunk 等日志管理方案
主动维护技巧
- 用脚本自动化重复性维护任务
- 详细记录更新和变更日志
- 定期查看性能报告,发现趋势
- 在故障发生之前规划硬件升级
专业建议:把监控与自动告警结合起来,在问题影响用户之前就加以处理。
小结:服务器监控
服务器监控与维护对于稳定、安全、高性能的 IT 基础设施至关重要。落实最佳实践并使用合适的工具,可保证持续可靠运行。
企业服务器预防性维护清单
- 每日(自动):备份任务结果、磁盘和 RAID 状态、失败的服务以及安全警报。
- 每周:查看告警历史中的规律,应用待安装的安全更新,并检查证书和域名的到期日期。
- 每月:从备份中还原一个示例文件或数据库,检查用户和管理员账户,并把资源趋势与上月比较。
- 每季度:测试 UPS 和自动关机,检查风扇和防尘滤网,并阅读服务器、存储和网络设备的固件说明。
- 每年:检查保修和支持到期日期、操作系统停止支持的日期,以及硬件是否仍能胜任当前的工作负载。
正常运行时间监控与系统健康
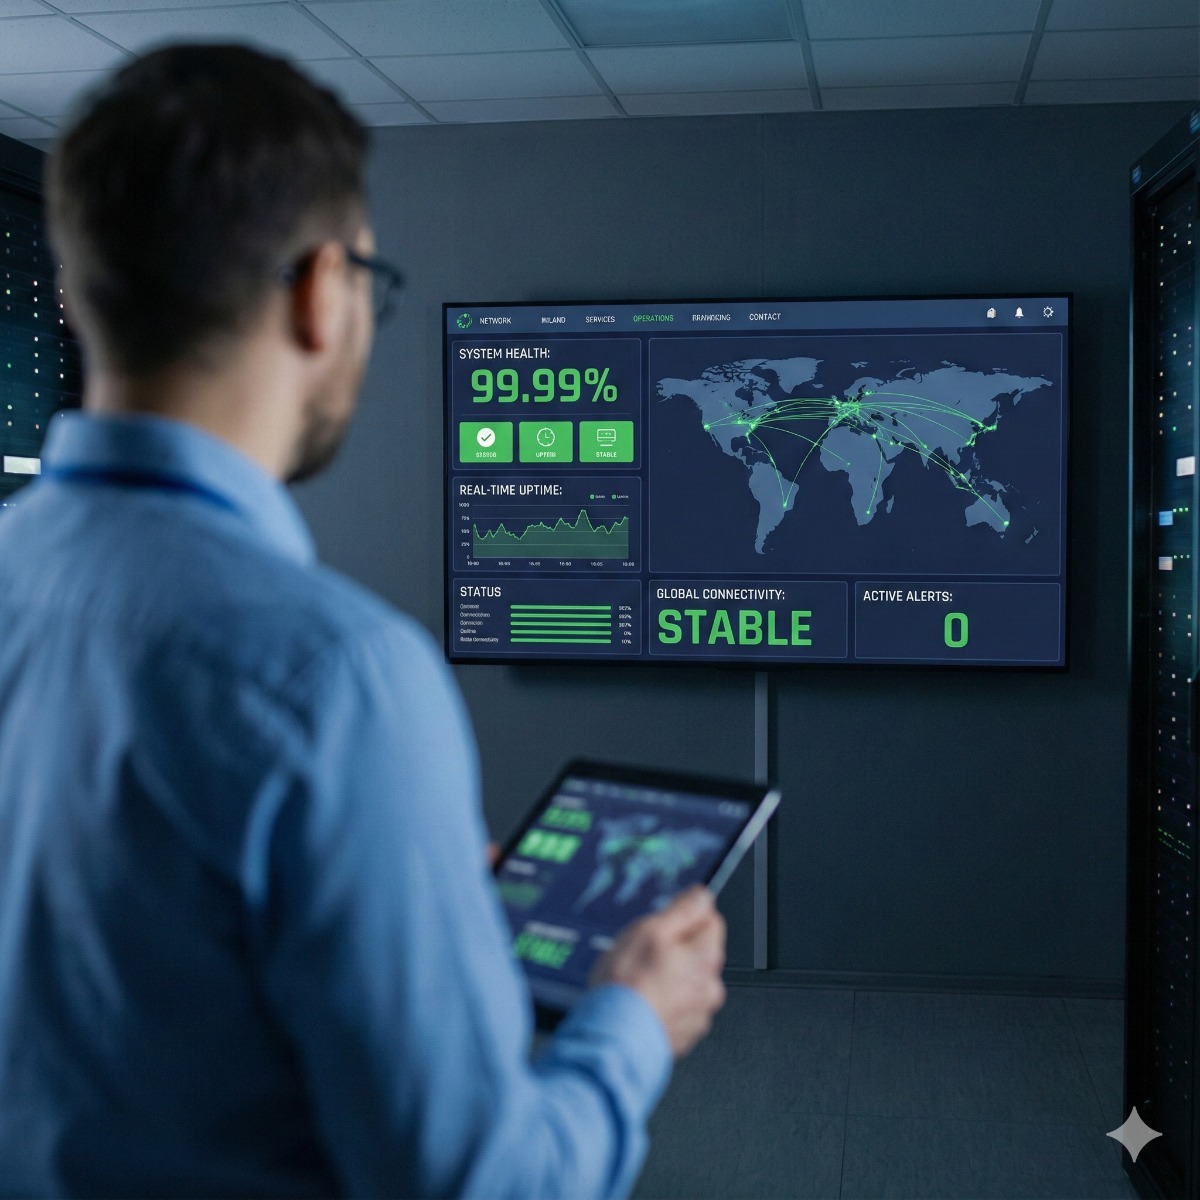
两者回答的是不同的问题。正常运行时间监控从您的网络之外检查网站、邮件服务器或 VPN 是否有响应,就像客户或远程员工所体验到的那样。系统健康监控运行在服务器上或其附近,关注的是成因:磁盘空间趋势、内存、温度、RAID 状态、数据库复制和备份是否成功。两者缺一不可,因为内部代理无法报告办公室的互联网线路本身已经中断。
选择服务器工具,而不被告警淹没
告警什么,比用哪个工具更重要。只有需要有人处理时才呼叫人员,把警告汇总到每日摘要中,磁盘告警应根据存储卷还有多久会写满来设置,而不是用固定阈值。每条告警都应说明哪里出了问题,并指向修复所用的运维手册。把防火墙、交换机、UPS 和互联网连接等更广泛的 IT 基础设施也纳入监控,有助于区分服务器故障与网络故障。
常见问题:服务器监控
服务器上应监控哪些内容?
每项服务的可用性、CPU 负载、内存、磁盘空间和磁盘健康、温度、网络流量、备份结果、待安装的安全更新以及证书到期时间。
服务器应多久维护一次?
自动检查持续运行,更新每周安装或在发布时安装,每月值得进行一次人工检查,每年再做一次更深入的硬件和生命周期评估。
服务器老到什么程度就不值得继续维护?
当厂商不再提供零件或固件、操作系统无法升级到受支持的版本,或者维修和停机的成本开始超过更换时。
需要帮助?我们的服务器监控与维护服务会为您执行这份清单,IT 托管服务把它延伸到整个办公室,服务器退役下线则让到达生命周期终点的硬件退役。申请报价。