




El servidor se reinició tras una actualización o un corte de energía y, en lugar de un indicador de inicio de sesión, la consola muestra un mensaje que empieza con "You are in emergency mode." Los sitios web están caídos, la base de datos es inaccesible, y los siguientes pasos obvios, reiniciar otra vez o pegar un comando de reparación encontrado en internet, son justamente los que pueden empeorar las cosas. El modo de emergencia de Linux no es un diagnóstico en sí mismo. Es systemd diciéndole que algo que el sistema necesita al arrancar, normalmente un disco o un sistema de archivos, no se levantó. Esta guía explica las causas comunes, qué revisar primero y cuándo detenerse y proteger los datos.
Qué significa el modo de emergencia de Linux
En las distribuciones basadas en systemd, como Debian, Ubuntu, AlmaLinux y Rocky Linux, el arranque se detiene en el objetivo de emergencia cuando falla un paso obligatorio. Con mayor frecuencia se trata del montaje de un sistema de archivos incluido en /etc/fstab, o de una comprobación del sistema de archivos que requiere que una persona decida qué hacer. El sistema ofrece entonces un shell de root mínimo, con el sistema de archivos raíz a menudo montado en solo lectura y casi ningún servicio en ejecución. El mensaje suele decir:
You are in emergency mode. After logging in, type "journalctl -xb" to view system logs, "systemctl reboot" to reboot, "systemctl default" or "exit" to boot into default mode.
El modo de rescate es su hermano más suave: monta los sistemas de archivos locales e inicia unos pocos servicios básicos. El modo de emergencia hace lo mínimo posible, y por eso aparece cuando el almacenamiento está en duda.
Causas comunes, de las inofensivas a las graves
- Un error de fstab. Una línea de /etc/fstab apunta a un disco que ya no está: una unidad USB de respaldo retirada, un disco reemplazado con un UUID nuevo o un error de escritura en una edición reciente. Es la causa más común y la menos peligrosa.
- Un sistema de archivos que necesita una comprobación manual. Tras un apagado incorrecto, la comprobación automática encuentra inconsistencias que no corregirá por sí sola y pide ejecutar fsck a mano.
- Un arreglo RAID o un volumen LVM que no se ensambló. Un arreglo RAID degradado que no arranca, o un volumen físico ausente, deja sin disponibilidad el sistema de archivos que está encima.
- Un disco defectuoso. Errores de lectura al montar, o un sistema de archivos que el kernel ya pasó a solo lectura para protegerlo.
Los tres primeros son problemas de configuración o de consistencia. El cuarto es un problema de hardware que se ve igual en pantalla, y tratarlo como los demás es la manera de perder datos que eran recuperables. Por eso nuestro trabajo de recuperación de servidores Linux siempre protege los datos antes de intentar cualquier reparación.
Qué revisar primero, sin cambiar nada
- Lea el registro. Ejecute journalctl -xb y busque las líneas en rojo. Una unidad de montaje fallida, "Timed out waiting for device" o "Dependency failed for" seguido de un punto de montaje le indican qué sistema de archivos es el problema.
- Compare los discos con fstab. lsblk -f y blkid muestran los discos y los UUID que el sistema puede ver. Si fstab espera un UUID que no está en la lista, el disco falta o fue reemplazado.
- Busque errores de hardware. Si dmesg muestra errores de E/S, o smartctl -H informa de una unidad defectuosa, el plan cambia: copie los datos antes de cualquier reparación.
- Revise el estado del RAID. cat /proc/mdstat muestra si los arreglos RAID por software están activos, degradados o inactivos.
Fotografíe la pantalla o guarde la salida antes de seguir. Esas notas son lo primero que le pedirá cualquiera que le ayude.
Arreglos seguros y los que conviene evitar
Una buena reparación del sistema Linux es sobre todo diagnóstico; el arreglo en sí suele ser una sola línea. Si el registro señala un disco no esencial, como una unidad de respaldo desconectada, vuelva a montar el sistema de archivos raíz en lectura y escritura con mount -o remount,rw /, comente esa línea o agregue la opción nofail para que el arranque ya no dependa del disco, y reinicie. Vale la pena agregar la opción nofail a todo disco sin el que el servidor pueda funcionar.
Si un sistema de archivos necesita comprobación y el disco está sano, ejecute fsck en el sistema de archivos desmontado, nunca en uno montado. Lo que debe evitarse:
- Ejecutar fsck -y una y otra vez en un disco que falla. Cada pasada puede mover o descartar datos que el disco apenas logra leer. Primero haga una imagen del disco, por ejemplo con GNU ddrescue, y repare la copia.
- Forzar un sistema de archivos de solo lectura a lectura y escritura. Cuando el kernel lo vuelve a montar en solo lectura tras errores, lo está protegiendo. Averigüe por qué antes de volver a escribir en él.
- Reinstalar para que el problema desaparezca. Una reinstalación sobre los mismos discos puede sobrescribir lo que aún era recuperable.
- Reiniciar repetidamente con la esperanza de que vuelva. Cada intento fuerza un disco que quizá ya esté fallando.
Cuando la cuenta root está bloqueada o no hay consola
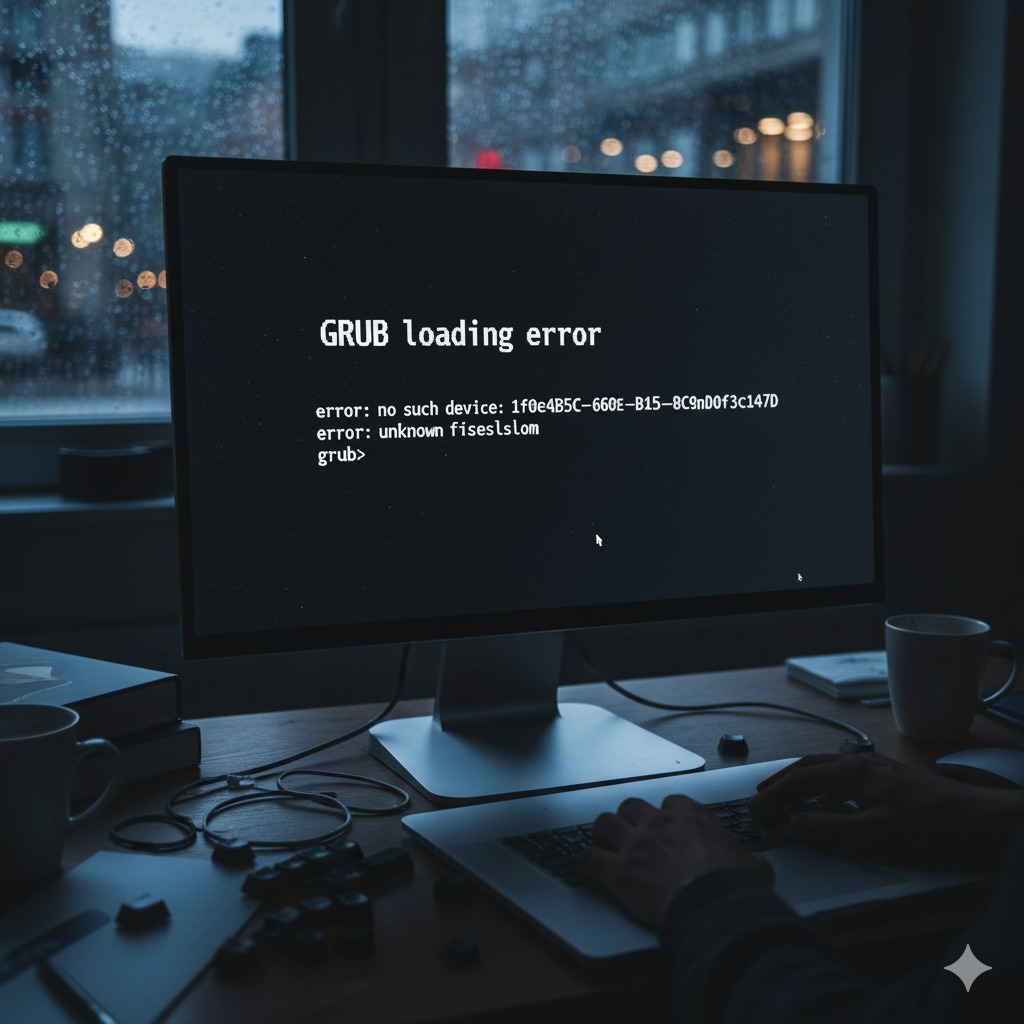
En Ubuntu y algunos otros sistemas la cuenta root no tiene contraseña de forma predeterminada, así que el modo de emergencia termina con "Cannot open access to console, the root account is locked" y sin ningún shell. La vía de entrada es entonces un sistema de rescate: el modo de rescate del proveedor de hosting o la consola KVM en un servidor alojado, o una memoria USB live en una máquina de su oficina. Desde allí se pueden inspeccionar los discos, copiar los datos y reparar la configuración. La misma vía se usa cuando el propio gestor de arranque está dañado, algo que cubre nuestra página de reparación de arranque GRUB y MBR.
Para el hardware en un cuarto de servidores, el acceso fuera de banda, como IPMI, iDRAC o iLO, ahorra un viaje, así que configúrelo y anote las credenciales mientras todo aún funciona.
Preguntas frecuentes: modo de emergencia de Linux
¿Es seguro presionar Control-D o escribir exit para seguir arrancando?
A veces el sistema arrancará, pero todo lo que dependiera del sistema de archivos ausente fallará o, peor, empezará a escribir en el punto de montaje vacío del disco raíz. Una base de datos o un recurso compartido de archivos puede terminar con datos nuevos en el lugar equivocado y los datos anteriores en el disco que no se montó. Averigüe primero la causa.
¿Cuál es la diferencia entre el modo de emergencia y el modo de rescate?
El modo de rescate monta los sistemas de archivos locales e inicia un conjunto pequeño de servicios básicos, por lo que sirve para reparaciones en un sistema sano. El modo de emergencia monta solo el sistema de archivos raíz, a menudo en solo lectura, y casi no inicia nada, lo que lo hace el lugar más seguro cuando el almacenamiento está en duda.
¿Por qué mi servidor pasó su disco a solo lectura?
Los sistemas de archivos como ext4 suelen configurarse para volver a montarse en solo lectura cuando detectan errores, de modo que el daño no se propague. El detonante puede ser un apagado incorrecto, pero a menudo es un disco o un controlador defectuoso, así que revise dmesg y los datos SMART de la unidad antes que nada.
¿Servidor atascado en el indicador de emergencia? Nuestro servicio de recuperación y reparación de sistemas Linux empieza con el diagnóstico y la protección de los datos, luego repara fallas de arranque, del sistema de archivos, del RAID y de servicios, y termina con un breve resumen por escrito. Para la reparación de Linux en Long Beach y el área de Los Ángeles, o un servidor alojado en cualquier lugar de EE. UU., contáctenos con la distribución, dónde está alojado el servidor y una foto de la última pantalla.